Akshat Mishra — ページの先頭へ

ソフトウェアエンジニア ・ コンピュータサイエンス専攻(2027年卒業予定)

Akshat Mishra

データベースとテストと数字が、きちんと噛み合うソフトウェアをつくっています。

2026年に、Java / Spring Boot、Python / FastAPI、PostgreSQL、React を使った5つのプロジェクトを設計・テスト・デプロイしました。2027年から日本で新卒ソフトウェアエンジニアとして働くことを目指しています。他の地域でのバックエンド・フルスタック・データ関連の職種にも関心があります。

2026年にデプロイしたプロジェクト
5
5プロジェクト合計の自動テスト
6,052
ソフトウェア開発インターン
2
英語(EF SET)・日本語(自己評価で JLPT N3 相当)
C2 ・ N3
01

自己紹介

制約、マイグレーション、リトライ、テスト、そして二つのリクエストが同時に届いたときの挙動。ソフトウェアの地味な部分こそ、丁寧に作りたいと思っています。

ベネット大学でコンピュータサイエンスを学んでおり、2027年に卒業予定です。2026年には5つのプロジェクトを開発・デプロイしました。どれも、ひとつの難しい問いを軸にしています。違反になるシフトを、データベース自身が拒否できるか。言語モデルの主張を、一行ずつ検証できるか。341の文法ルールを、ニューラルネットワークなしで数ミリ秒で照合できるか。

中心はバックエンドです。Java と Spring Boot、Python と FastAPI、その下に PostgreSQL。フロントエンドは React と TypeScript、周辺は Docker、GitHub Actions、Azure です。5つのうち2つはデータ系のプロジェクトで、ETL パイプライン、SQL マート、限界を明示した統計分析で構成されています。

2回のインターンシップではチーム開発を経験しました。5人のチームで Spring Boot と MySQL による研究ポータルを開発し、別の会社では React で企業サイトのページを制作しました。

日本語は学習中です(自己評価で JLPT N3 相当)。3つのプロジェクトには日本語 UI があり、1つは日本語そのものを題材にしています。

所在地
インド・ニューデリー(UTC+5:30)
学位
B.Tech(コンピュータサイエンス・エンジニアリング)・ベネット大学・2027年卒業予定
希望
2027年からの日本での新卒ソフトウェアエンジニア職。その他の地域でのバックエンド・フルスタック・データ関連職、およびそれ以前のインターンシップ。
言語
英語:C2(EF SET 71/100)。日本語:自己評価で JLPT N3 相当(資格は未取得)。
02

プロジェクト

2026年10月〜11月に開発した、5つの完成済みプロジェクトです。すべてデプロイ済みで、自動テストを備え、できないことも明記しています。いずれも個人プロジェクトで、実ユーザー・トラフィック・収益はありません。

  1. 01 Yoyū 日本で学ぶ留学生のための、アルバイト時間管理アプリ。 フルスタック ・ バックエンド
  2. 02 Kensa 失敗した GitHub Actions を調査する、ローカルファーストのツール。 AI エンジニアリング ・ 開発者ツール
  3. 03 Kaidoku どんな文章でも文法が見える、日本語読解ツール。 バックエンド ・ アルゴリズム ・ PWA
  4. 04 MIERU すべての数字の出どころが見える、小売データ分析プラットフォーム。 データ分析 ・ データサイエンス
  5. 05 Hoshizora すべての数字に出典がある、日英対応の宇宙データ分析プラットフォーム。 データエンジニアリング ・ 分析
  6. 06 KIZASHI 日本の電力需要予測。現在開発中のため、結果・スクリーンショット・リンクはまだありません。 開発中

01/ 052026年10月〜11月

Yoyū

余裕(よゆう)

日本で学ぶ留学生のための、アルバイト時間管理アプリ。

フルスタック ・ バックエンド

無料枠のため、初回表示に約40秒かかります。
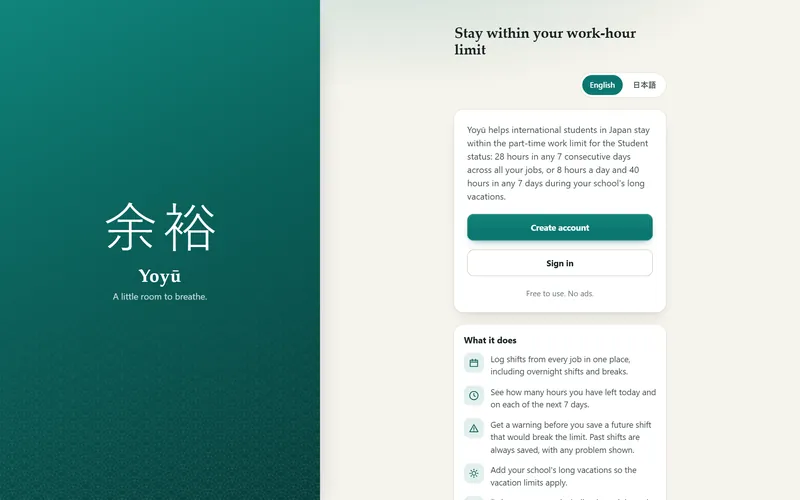
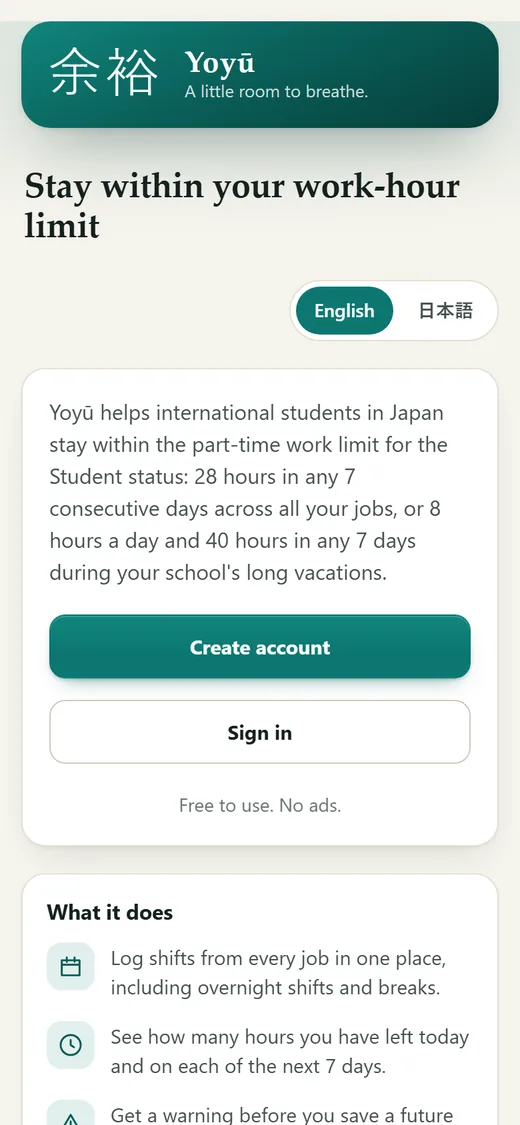
Yoyū のトップページ。「Stay within your work-hour limit」の見出し、英語/日本語切り替え、アカウント作成ボタン、機能一覧。 (新しいタブで開きます)
スマートフォン幅で表示した Yoyū のトップページ。
稼働中のアプリのスクリーンショット(2026年11月15日撮影)。

課題

日本の留学生は、すべてのアルバイトを合算して「連続する7日間で28時間以内」しか働けません。雇用主は自分の職場の勤務時間しか把握していないため、合計を管理できるのは本人だけです。

実装したもの

英語・日本語対応の、インストール可能な PWA です。フレームワークに依存しない純粋な Java のルールエンジンが、すべての7日間ウィンドウ、日付をまたぐシフト、長期休暇中の上限を判定し、Spring Boot の REST API として提供します。シフトの重複は PostgreSQL 自体が拒否します。

技術的なポイント

  • データベースで整合性を保証:GiST 排他制約でシフトの重複を防止。ユーザー単位の行ロック、楽観ロック、冪等キーにより、同時書き込みやリトライでも一貫性を維持。
  • Spring Security による Google・LINE ログイン(OAuth 2.0 / OpenID Connect、PKCE)。メール認証コードは HMAC でハッシュ化し、CSRF 対策とレート制限も実装。
  • シフト表の取り込みは端末内で完結:PDF.js と Tesseract.js(OCR)をブラウザ上で実行し、取り込んだデータは一括で保存(全件成功か全件失敗)。
  • 無料枠(Azure App Service と Neon PostgreSQL)で運用しているため、アイドル後の初回表示には約40秒かかります。
REST エンドポイント
42
Flyway マイグレーション
10
バックエンドテスト(JUnit 5、Testcontainers)
511
フロントエンドテスト(Vitest)
537

使用技術

  • Java 21
  • Spring Boot 4
  • Spring Security
  • PostgreSQL 16
  • Flyway
  • React 19
  • TypeScript
  • PWA
  • Docker
  • Azure App Service

処理の流れ
  1. React PWA
  2. Spring Security:セッション、CSRF、OIDC
  3. REST コントローラとバリデーション
  4. サービス層:ユーザーロック、冪等性
  5. 純粋な Java のルールエンジン
  6. PostgreSQL:GiST 排他制約
制約と注意点
  • 個人プロジェクトで、実ユーザーはいません。
  • デプロイは手動で、自動化したブラウザ E2E テストはありません。
  • 現行のソースコードは非公開リポジトリにあるため、リンクは稼働中のアプリのみです。
02/ 052026年10月〜11月

Kensa

検査(けんさ)

失敗した GitHub Actions を調査する、ローカルファーストのツール。

AI エンジニアリング ・ 開発者ツール

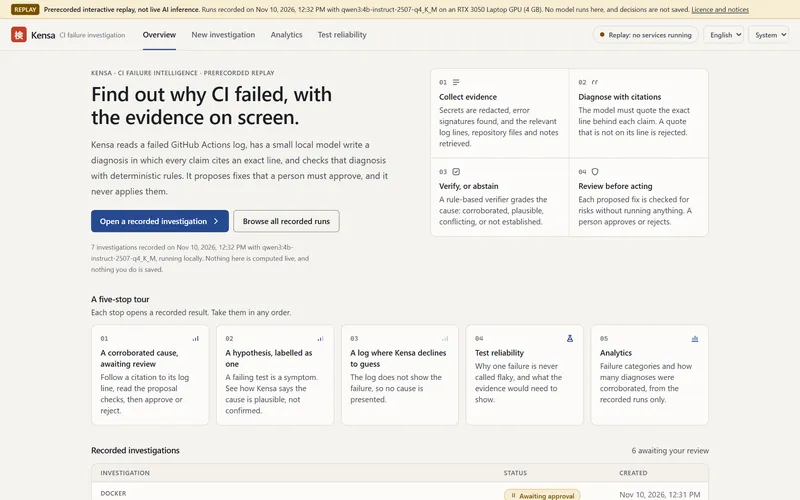
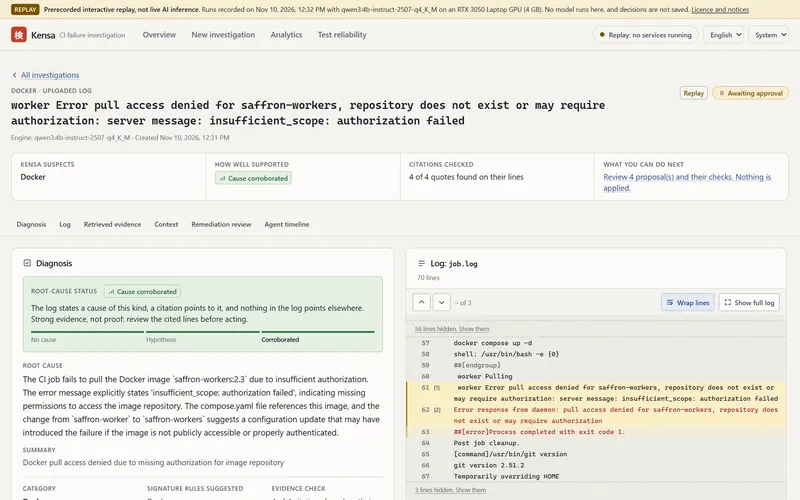
公開リプレイ上の Kensa のレポート画面。「cause corroborated」と表示された診断と、引用されたログ行。 (新しいタブで開きます)
Kensa の概要ページ。ライブの AI 推論ではなく事前記録のリプレイであることを示すバナー。
稼働中のアプリのスクリーンショット(2026年11月15日撮影)。

注記 公開ページは、事前に記録した7件の調査を再生する静的なインタラクティブ・リプレイです。このページ上でモデルやバックエンドは動いていません。

課題

CI が失敗したとき、原因は数千行のログのどこかにあります。言語モデルはそれらしい要約を書けますが、間違っていても要約からは見分けがつきません。

実装したもの

FastAPI のバックエンドがログ、ワークフロー、失敗したコミットから証拠を集め、PostgreSQL と pgvector 上の全文検索とベクトル検索を組み合わせたハイブリッド検索で関連情報を取得します。Ollama で動かすローカルの量子化モデル(Qwen3 4B)が、ログ行の引用を必須とした診断を作成し、すべての引用を保存済みの証拠と決定的に照合します。

技術的なポイント

  • 検証できる出力:ホールドアウトの合成データセットで、採用された引用646件すべてが実際のログ行と一致。修正案には人の承認が必要で、自動適用はしません。
  • PostgreSQL のジョブキュー上で動く、クラッシュから再開可能な LangGraph ワークフロー(FOR UPDATE SKIP LOCKED、リース、フェンシングトークン、バックオフ付きリトライ)。
  • 31テーブルと15本の可逆な Alembic マイグレーション。CI 履歴の増分 ETL、不安定なテスト(flaky test)の分析、OpenTelemetry によるトレーシング。
  • 推論は Ollama を使ってノート PC の GPU 上で実行し、有料 API は使いません。
採用された引用が実在(ホールドアウト合成データ)
646 / 646
バックエンドテスト(pytest)
666
フロントエンドテスト(Vitest)
83
E2E テスト(Playwright)
30

使用技術

  • Python 3.13
  • FastAPI
  • PostgreSQL 18
  • pgvector
  • LangGraph
  • Ollama
  • React
  • TypeScript
  • Playwright
  • OpenTelemetry

処理の流れ
  1. 失敗した実行:ログ、ワークフロー、コミット
  2. 取り込み:秘密情報の除去、分割
  3. ジョブキュー:SKIP LOCKED、リース
  4. 検索:全文検索とベクトル検索
  5. 診断:ローカルモデル、引用必須
  6. 引用を決定的に検証
  7. 人が承認または却下
制約と注意点
  • 精度の数値は合成データセットでの評価で、実際の CI 障害での値ではありません。
  • 測定ではハイブリッド検索は全文検索のみの場合を上回らず、その結果をそのまま報告しています。
  • 一人がローカルで使うツールで、ログイン機能やホストされた AI サービスはありません。

03/ 052026年10月〜11月

Kaidoku

解読(かいどく)

どんな文章でも文法が見える、日本語読解ツール。

バックエンド ・ アルゴリズム ・ PWA

アイドル時は停止するため、初回表示に約20秒かかることがあります。

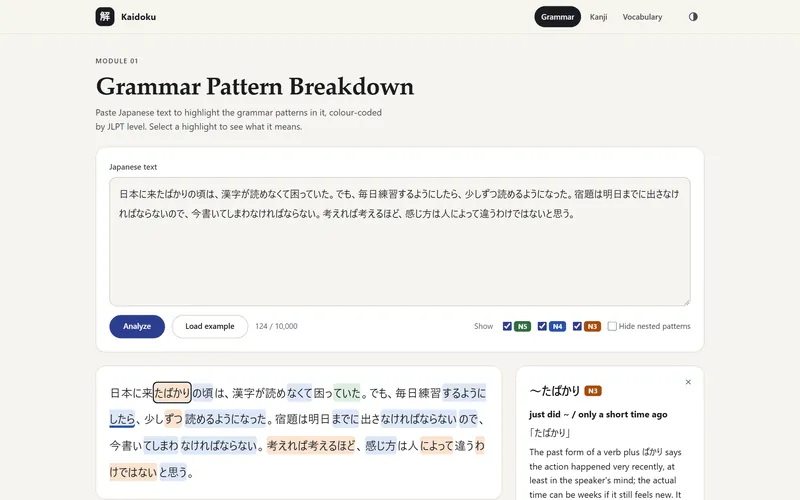
Kaidoku の文法解析画面。JLPT レベル別に文法パターンがハイライトされた日本語の文章と、解説パネル。 (新しいタブで開きます)
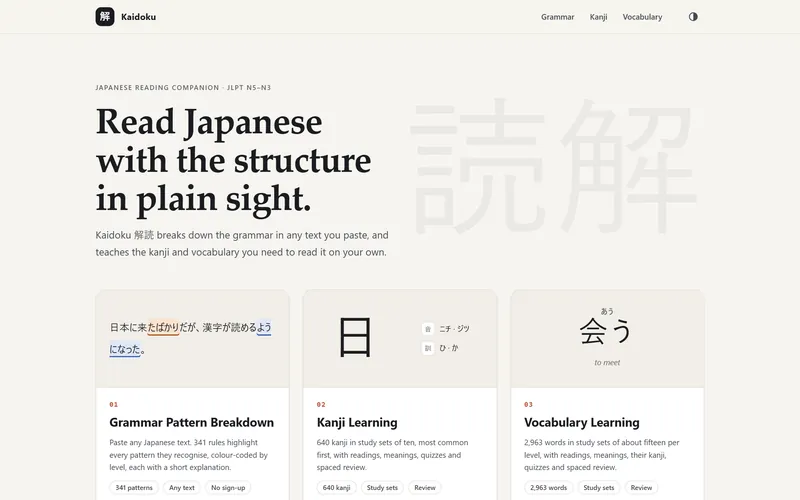
Kaidoku のホーム画面。文法・漢字・語彙の3つのモジュール。
稼働中のアプリのスクリーンショット(2026年11月15日撮影)。

課題

単語は辞書で調べられますが、文法は活用した文の中に隠れています。Kaidoku は文中の文法パターンをその場でハイライトし、関連する漢字と語彙も学べるようにします。

実装したもの

Kuromoji の形態素解析結果に対して動く、決定的なルールエンジンです(ルールベースで、機械学習は使っていません)。JLPT N5〜N3 の文法ルール341件をデータとして定義し、BitSet を使った NFA 方式でバックトラックなしに照合します。あわせて、漢字640字と語彙2,963語を、検証済みの読み問題2,926問と SM-2 方式の間隔反復で学べる、オフライン対応の PWA を実装しました。

技術的なポイント

  • 測定に基づく精度:初期の199ルールを対象とした655文の回帰セットで、適合率99.2%・再現率98.9%。下限値を CI で強制しています。
  • 1万文字の照合に約13ミリ秒(ローカル環境でのベンチマーク)。
  • 学習の進捗はブラウザ内に保存:トランザクション処理した IndexedDB、バックアップと復元、バージョン管理した Service Worker キャッシュ。
  • GitHub Actions で Docker イメージをビルドし、Azure Container Apps で稼働。
JLPT N5〜N3 の文法ルール
341
655文の回帰セットでの適合率
99.2%
ユニット/統合テスト
3,374
ブラウザテスト(Playwright)
78

使用技術

  • Java 21
  • Spring Boot
  • Kuromoji
  • JavaScript
  • IndexedDB
  • Service Worker
  • Docker
  • GitHub Actions
  • Azure Container Apps
  • Playwright

処理の流れ
  1. 日本語テキスト(最大1万文字)
  2. Kuromoji による形態素解析
  3. 候補インデックスでルールを絞り込み
  4. BitSet NFA マッチャー(341ルール)
  5. JLPT レベル別の一致結果
  6. ハイライト表示と解説
制約と注意点
  • 評価用の文はモデルが生成したもので、ネイティブスピーカーによるレビューは受けていません。
  • 画面は英語のみです。
  • 対象は JLPT N5〜N3 です。ルールベースで、機械学習は使っていません。

04/ 052026年10月〜11月

MIERU

見える(みえる)

すべての数字の出どころが見える、小売データ分析プラットフォーム。

データ分析 ・ データサイエンス

アイドル時は停止するため、初回表示に数秒かかります。

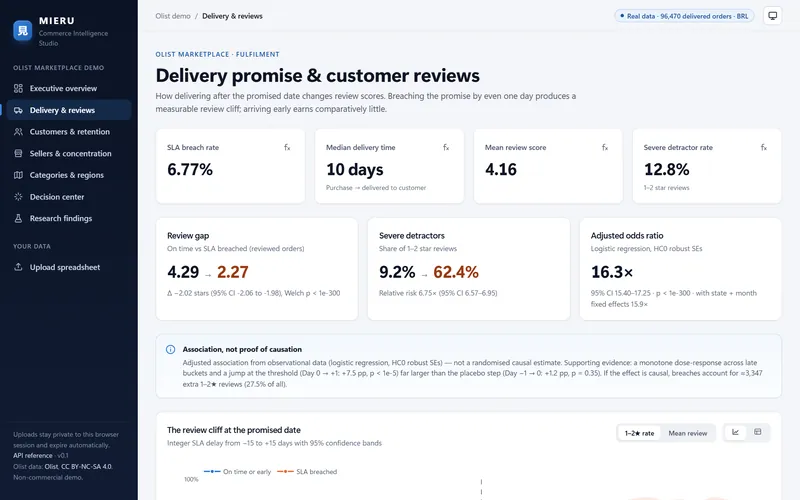
MIERU の配送・レビュー分析ダッシュボード。SLA 超過率、レビュー差、調整済みオッズ比16.3、因果関係の証明ではないという注記。 (新しいタブで開きます)
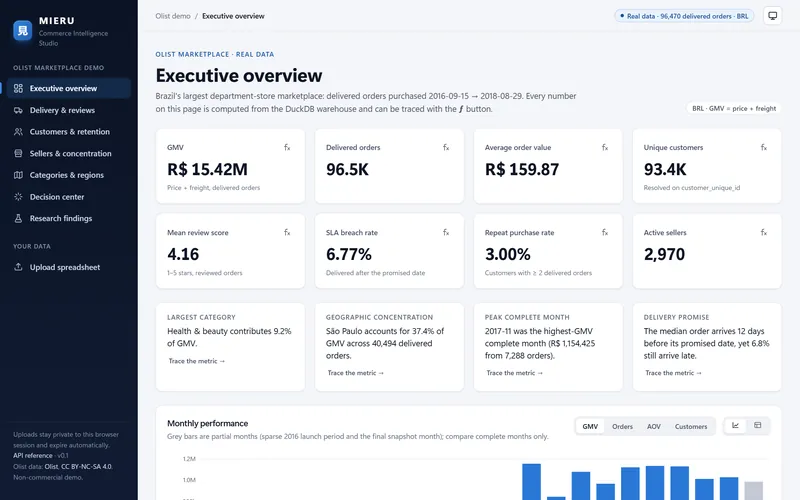
MIERU のエグゼクティブ概要。Olist デモの GMV、配送済み注文数、平均注文額、月次推移。
稼働中のアプリのスクリーンショット(2026年11月15日撮影)。

課題

売上データは、文字コードの混在、意味のあいまいな列、二重計上された合計など、整っていない状態で届きます。その上に作ったダッシュボードは、見えないクレンジング処理の品質以上には信頼できません。

実装したもの

FastAPI、DuckDB、pandas で構築したアプリケーションです。アップロードされた CSV / Excel の文字コード(Shift_JIS を含む)、区切り文字、列の役割を自動判定し、標準スキーマに変換したうえで、取り消し可能で監査ログの残るデータ品質ポリシーを適用します。指標はパラメータ化した DuckDB SQL で実装しました:売上ブリッジ、ルールベースの RFM 分析、右側打ち切りを考慮したコホート、パレート/ジニ係数による集中度。

技術的なポイント

  • 公開データセット Olist で検証:汎用アップロード経路で読み込んだ112,650件の注文明細が、直接 SQL で計算した結果と完全に一致。7つの DuckDB マートが、配送済み注文96,470件のダッシュボードを支えます。
  • 限界を明示した統計分析:カイ二乗検定、Welch の t 検定、Mann–Whitney 検定、ロジスティック回帰。配送予定日の超過は、星1〜2のレビューとなるオッズが16.3倍であることと関連(95% CI 15.4–17.3、観察データ)。
  • ベースラインと比較した予測:Ridge 回帰とランダムフォレストを、ローリングオリジン方式のバックテストで単純なベースラインと比較。結果は単純なベースラインの勝ちで、アプリにもそのまま表示しています。
ダッシュボードの対象となる配送済み注文(Olist)
96,470
直接 SQL と完全一致したアップロード明細
112,650
配送遅延後に星1〜2となるオッズ(観察データ)
16.3×
テスト:バックエンド119、フロントエンド113
232

使用技術

  • Python 3.14
  • FastAPI
  • DuckDB
  • pandas
  • NumPy
  • SciPy
  • statsmodels
  • scikit-learn
  • React 19
  • TypeScript
  • Plotly
  • Docker
  • Azure Container Apps

処理の流れ
  1. CSV / Excel ファイル
  2. 解析:文字コード、区切り文字、列の役割
  3. 標準スキーマ
  4. 品質ポリシー:取り消し可能、監査ログ付き
  5. DuckDB マートと指標 SQL
  6. 統計検定とバックテスト
  7. ダッシュボードとエクスポート
制約と注意点
  • Olist はブラジルのマーケットプレイスの公開データセットで、顧客企業のデータではありません。
  • 分析結果は観察データに基づくもので、因果関係を示すものではありません。
  • RFM 分析はルールベースです。日本語 UI は未実装です。

05/ 052026年10月

Hoshizora

星空(ほしぞら)

すべての数字に出典がある、日英対応の宇宙データ分析プラットフォーム。

データエンジニアリング ・ 分析

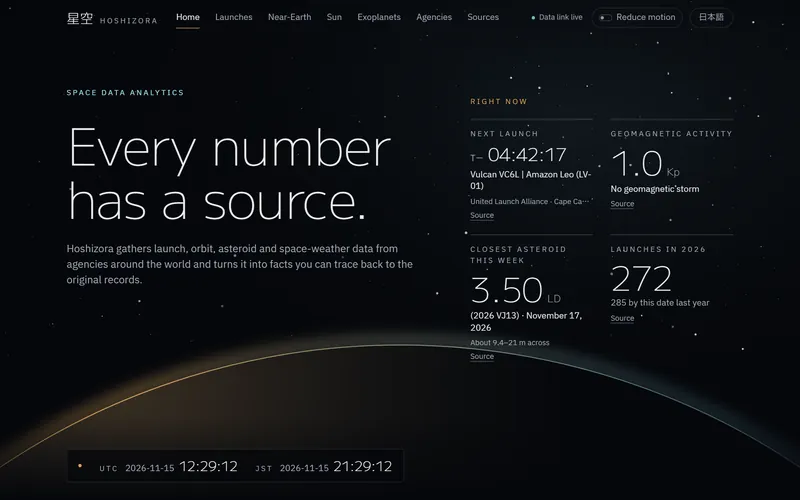
Hoshizora のホーム画面。「Every number has a source」の見出しと、次の打ち上げまでのカウントダウン、現在の宇宙天気の数値。 (新しいタブで開きます)
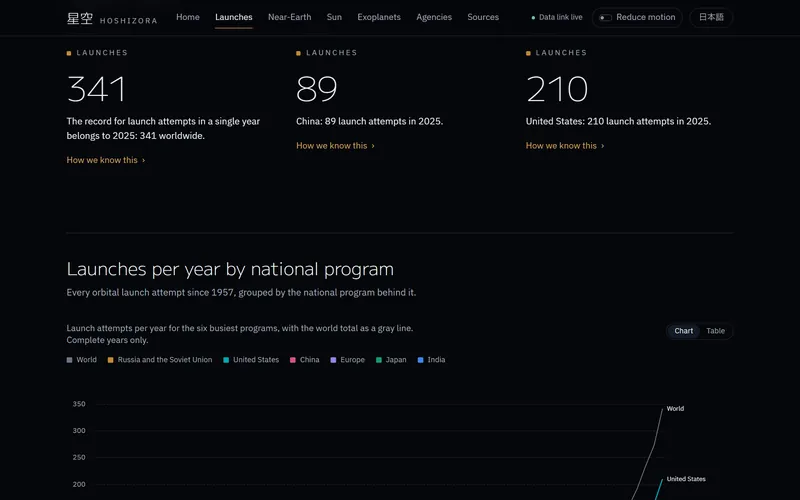
Hoshizora の打ち上げページ。打ち上げに関する事実と、国別の年間打ち上げ数の折れ線グラフ。
稼働中のアプリのスクリーンショット(2026年11月15日撮影)。

課題

ロケット打ち上げ、人工衛星、小惑星、宇宙天気、系外惑星のデータは、形式も利用制限も更新頻度も異なる5つの公開 API に分散しています。グラフは、元のデータまでたどれてはじめて信頼できます。

実装したもの

Python 3.14 の ETL パイプラインが生データを保存・正規化し、PostgreSQL 18 上の SQL マートを更新します(raw・core・mart・fact の4層、Flyway マイグレーション21本、マテリアライズドビューのマート15個)。読み取り専用の Java 25 / Spring Boot 4 API(GET ルート29本)が、React と ECharts による日英2言語のフロントエンドにデータを提供します。

技術的なポイント

  • 利用制限を守り、途中から再開できる取り込み処理:ソースごとのレート制限、指数バックオフ、ウォーターマークによる増分ロード、SHA-256 で重複排除した生データ保存、冪等な upsert。
  • 設計段階から組み込んだデータリネージ:392,534件のリンクで、各行を元のレコードまでたどれます。
  • SQL による分析:ウィンドウ関数、条件付き集計、マテリアライズドビューで、国別の打ち上げ頻度、直近20回の成功率、ブースター再使用の推移、系外惑星のサイズ分布を算出。
打ち上げ
8,147
登録された宇宙物体
71,090
小惑星の接近記録
52,153
自動テスト
541

使用技術

  • Python 3.14
  • SQL
  • PostgreSQL 18
  • Flyway
  • Java 25
  • Spring Boot 4
  • React 19
  • TypeScript
  • ECharts
  • Docker
  • Azure

処理の流れ
  1. 5つの公開 API
  2. Python ETL:レート制限、バックオフ
  3. raw:ハッシュ化した生データ
  4. core:正規化、リネージ付き
  5. mart:マテリアライズドビュー
  6. 読み取り専用の Spring Boot API
  7. React と ECharts(日英)
制約と注意点
  • 定期取り込みは一部停止中です。1つのソースが2026年10月22日から保留になっており、一部のデータは数週間前のものです。
  • リアルタイムのデータ配信ではありません。
  • pandas や機械学習は使っておらず、分析はすべて SQL です。
03

技術スタック

分野ごとにまとめています。すべて、5つのプロジェクトまたはインターンで実際に使った技術です。プロジェクトを選ぶと、そこで使った技術が強調されます。

プログラミング言語

  • Java
  • Python
  • TypeScript
  • JavaScript
  • SQL

バックエンド・API

  • Spring Boot
  • Spring Security
  • Spring MVC
  • JPA / Hibernate
  • FastAPI
  • SQLAlchemy
  • REST APIs
  • OAuth 2.0 / OIDC

データベース

  • PostgreSQL
  • MySQL
  • DuckDB
  • pgvector
  • Flyway
  • Alembic
  • トランザクションと同時実行制御
  • ウィンドウ関数、マテリアライズドビュー
  • データモデリング

データエンジニアリング・分析

  • ETL パイプライン
  • 増分・冪等ロード
  • データ品質チェック
  • データリネージ
  • pandas
  • NumPy
  • SciPy
  • statsmodels
  • scikit-learn
  • 仮説検定
  • ロジスティック回帰
  • RFM・コホート分析
  • 予測のバックテスト
  • ECharts
  • Plotly

フロントエンド

  • React
  • Vite
  • HTML
  • CSS
  • PWA
  • Service workers
  • IndexedDB
  • Figma

AI エンジニアリング

  • LangGraph
  • Ollama(ローカル LLM)
  • 検索拡張生成(RAG)
  • Kuromoji(日本語形態素解析、ルールベース)

テスト・可観測性

  • JUnit 5
  • MockMvc
  • Testcontainers
  • pytest
  • Vitest
  • Playwright
  • OpenTelemetry

DevOps・クラウド

  • Docker
  • Docker Compose
  • GitHub Actions(CI)
  • Azure App Service
  • Azure Container Apps
  • Git
  • Linux
04

設計の考え方

大切にしている6つの習慣と、それをプロジェクトのどこで確認できるか。

  1. ルールは、迂回できない場所に置く。

    • Yoyū

      Yoyū シフトの重複は、アプリケーションのコードだけでなく PostgreSQL の GiST 排他制約で拒否します。

    • Kaidoku

      Kaidoku 文法ルールはデータとして管理し、精度の下限を CI で強制。精度を下げる変更はビルドが失敗します。

    • Hoshizora

      Hoshizora 未対応のコードが届いた場合は、データ品質チェックが取り込みを止めます。

  2. リクエストは同時に届くものと考える。

    • Yoyū

      Yoyū ユーザー単位の行ロック、楽観ロック、冪等キーで、同時書き込みやリトライでも一貫性を保ちます。

    • Kensa

      Kensa ジョブキューは FOR UPDATE SKIP LOCKED でジョブを取得し、リースとフェンシングトークンで保護します。

    • Hoshizora

      Hoshizora 冪等な upsert により、取り込みを繰り返しても結果は変わりません。

  3. 主張は、検証できる形にする。

    • Kensa

      Kensa モデルにはログ行の引用を必須とし、各引用を保存済みの証拠と決定的に照合します。

    • MIERU

      MIERU 汎用アップロードで読み込んだ112,650件の明細が、直接 SQL の結果と完全に一致することをテストしています。

    • Hoshizora

      Hoshizora 392,534件のリネージリンクが、各行と元のレコードを結びます。

  4. 壊れやすい境界をテストする。

    • Yoyū

      Yoyū 511件のバックエンドテストを Testcontainers 上の実際の PostgreSQL で実行。フロントエンドテストは537件。

    • Kaidoku

      Kaidoku ユニット/統合テスト3,374件と、Playwright によるブラウザテスト78件。

    • Kensa

      Kensa バックエンド666件、フロントエンド83件、E2E 30件のテストが CI で成功。

  5. セキュリティは、機能の一部として作る。

    • Yoyū

      Yoyū PKCE 付きの OAuth 2.0 / OpenID Connect、HMAC でハッシュ化したメール認証コード、CSRF 対策、レート制限。

    • Kensa

      Kensa 修正案には人の承認が必要で、自動で適用されることはありません。

    • MIERU

      MIERU アップロードしたデータはブラウザのセッション内に限定され、サイズ制限と自動削除があります。エクスポートは数式インジェクション対策済みです。

  6. 得られた結果を、そのまま報告する。

    • MIERU

      MIERU Ridge 回帰とランダムフォレストはローリングオリジン方式のバックテストで単純なベースラインに及ばず、アプリにもそう表示しています。

    • Kensa

      Kensa 測定ではハイブリッド検索は全文検索を上回らなかったため、上回るとは主張していません。

    • Kaidoku

      Kaidoku 精度には注記を添えています。評価用の文はモデルが生成したもので、ネイティブスピーカーのレビューは受けていません。

05

経歴・学歴

インターンシップ

  1. 2026年1月 – 2026年2月

    ソフトウェア開発インターン

    Ornate TechnoServices Pvt. Ltd. · インド・グレーターノイダ(出社)

    • 研究者のプロフィールと研究記録を保存・検索する、開発中の政府関連の研究ポータルで、Java / Spring Boot、React、MySQL を使ったバックエンド・フロントエンド・データ管理のタスクを担当。
    • 5人のチームで、Git / GitHub と毎日のスタンドアップを通じて開発。変更はチームのコードベースにマージされました。
  2. 2025年6月 – 2025年7月

    Web 開発インターン

    Medelan Life Sciences Pvt. Ltd. · インド・ガーズィヤーバード(ハイブリッド)

    • もう一人の開発者とともに、React、JavaScript、HTML、CSS で企業サイトのページを制作(一部は単独で担当)。
    • Figma でページレイアウトを設計し、定期的なレビューのフィードバックをもとに改善。変更は Git / GitHub で管理。

学歴

  1. 2023年 – 2027年(卒業予定)

    B.Tech(コンピュータサイエンス・エンジニアリング)

    ベネット大学 · インド・グレーターノイダ

    • 履修科目:データ構造、アルゴリズム、オブジェクト指向プログラミング、データベース管理システム、オペレーティングシステム、コンピュータネットワーク。
  2. CBSE(インド中央中等教育委員会)

    St Thomas School · インド・ウッタル・プラデーシュ州ガーズィヤーバード

言語

  • 英語C2EF SET 71/100
  • 日本語N3 相当自己評価で JLPT N3 相当。資格は未取得。

競技プログラミング

07

履歴書

2種類、各1ページ。どちらも2026年11月版です(PDF は英語です)。

08

連絡先

2027年入社の採用について、ぜひお話しさせてください。

2027年から日本で新卒ソフトウェアエンジニアとして働ける機会を探しています。それ以前のインターンシップや、他の地域でのバックエンド・フルスタック・データ関連の職種も歓迎です。ご連絡はメールが確実です。

akshatm.work23@gmail.com

現地時刻: ニューデリー 東京